进化什么时候值得学习
在第一版世界里,大脑没有长大,因为动物没有什么需要记住的。在第二版中,我给了它们终生学习的能力,并检验学习会在什么样的世界中进化出来。学习恰好出现在理论预言的地方。而大脑依然没有长大。
evo-brain-sim 原型的第二次迭代。这是玩具模型,不是科学研究:结论只适用于这个模型。2026 年 10 月。
这是第一次迭代的续篇,当时没有发现“气候多变 → 大脑更大”的关联。当时的主要假设是:没有记忆和学习,变化的世界不会给大脑带来优势。
简而言之
- 当世界在代际之间变化、而在一生之内保持稳定时,学习才划算。如果世界从不变化,知识会转入基因;如果变化太快,学到的东西还没回本就过时了。这支持了斯蒂芬斯的经典假说。
- 适度的变化最好,而不是最频繁的变化。学习的峰值出现在“正确的”食物每隔几代才变一次的地方,而不是每代都变。
- 学习对个体有利,对物种无益。会学习的个体从不会学习的邻居那里抢走好食物。但一个谁都不会学习的种群,过得并不更差。
- 大脑和记忆没有长大。这是模型的构造决定的:在模型中学习不需要神经元。这是模型的局限,而不是关于自然的发现。
世界有什么变化
不再是漂移的气候,而是六块肥沃的斑块在地图上游走。斑块有两种颜色:一种颜色的食物有营养,另一种是空的。哪种颜色是“好”的会发生变化,由两个旋钮控制:
- 代际之间。每“一代”(100 个时间步,约为平均寿命)好颜色以一定概率翻转:从“从不”到“每次都翻”。
- 一生之内。在个体一生中颜色翻转的频率:从“从不”到“约每 6 步一次”。
动物新增了:
- 颜色价值——对某种颜色食物的趋向。它由先天部分(在基因中,会突变)和习得部分(出生时为零,不遗传)相加而成。
- 学习——习得部分按一条简单规则变化:“吃了什么”ד比预期更好还是更差”。学习速率可遗传,零表示“不学习”。学习要消耗能量,最高时相当于一个神经元。
- 记忆——最多四个记住上一步的神经元,每个的代价与普通神经元相同。
开始时谁都不会学习。第二次迭代中没有捕食者:在新世界里它们总是灭绝。
通往可用模型的道路并不直接,这本身也是结果。起初,“根据奖励学习网络的全部权重”反而有害:即使在没什么可学的地方,学习者也输给了不学习的个体。直到基因和学习以平等的方式承担同一个任务——颜色价值——模型才奏效。
纯粹的机制
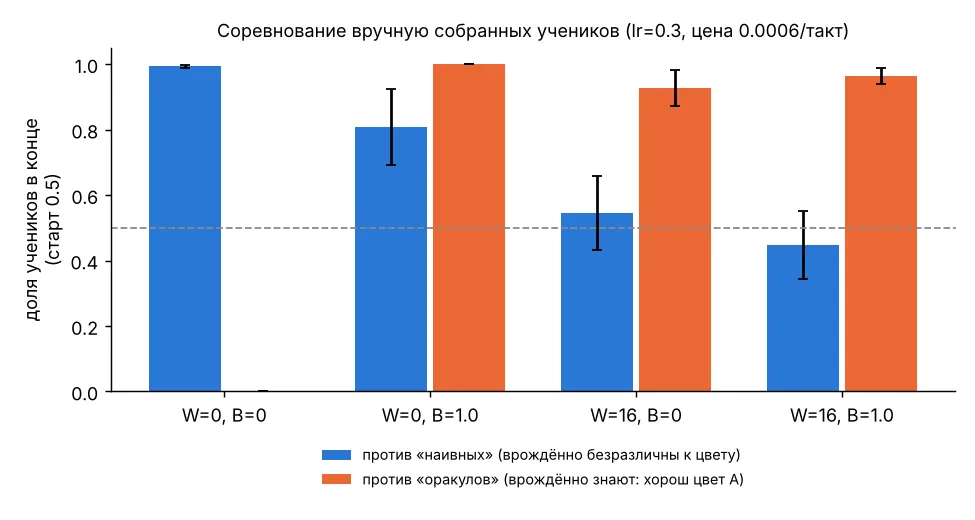
先不加进化:种群一半是“学习者”,一半是对手。看 1200 步之后学习者还剩多少比例。
| 世界 | 稳定 | 代际之间变化 | 一生之内快速变化 | 一生之内和代际之间都快速变化 |
|---|---|---|---|---|
| 学习者 vs “天真者”(两种颜色都喜欢) | 0.99 | 0.81 | 0.54 | 0.45 |
| 学习者 vs “先知”(天生知道答案) | 0.00 | 1.00 | 0.93 | 0.96 |
在稳定的世界里,先天知识胜过学习:先知获胜。当世界在代际之间变化时,学习胜过基因。当世界变化太快时,学习者并不比天真者好。先知在那里输给所有人:它们的“知识”有一半时间是有害的。
主图:学习在哪里进化出来
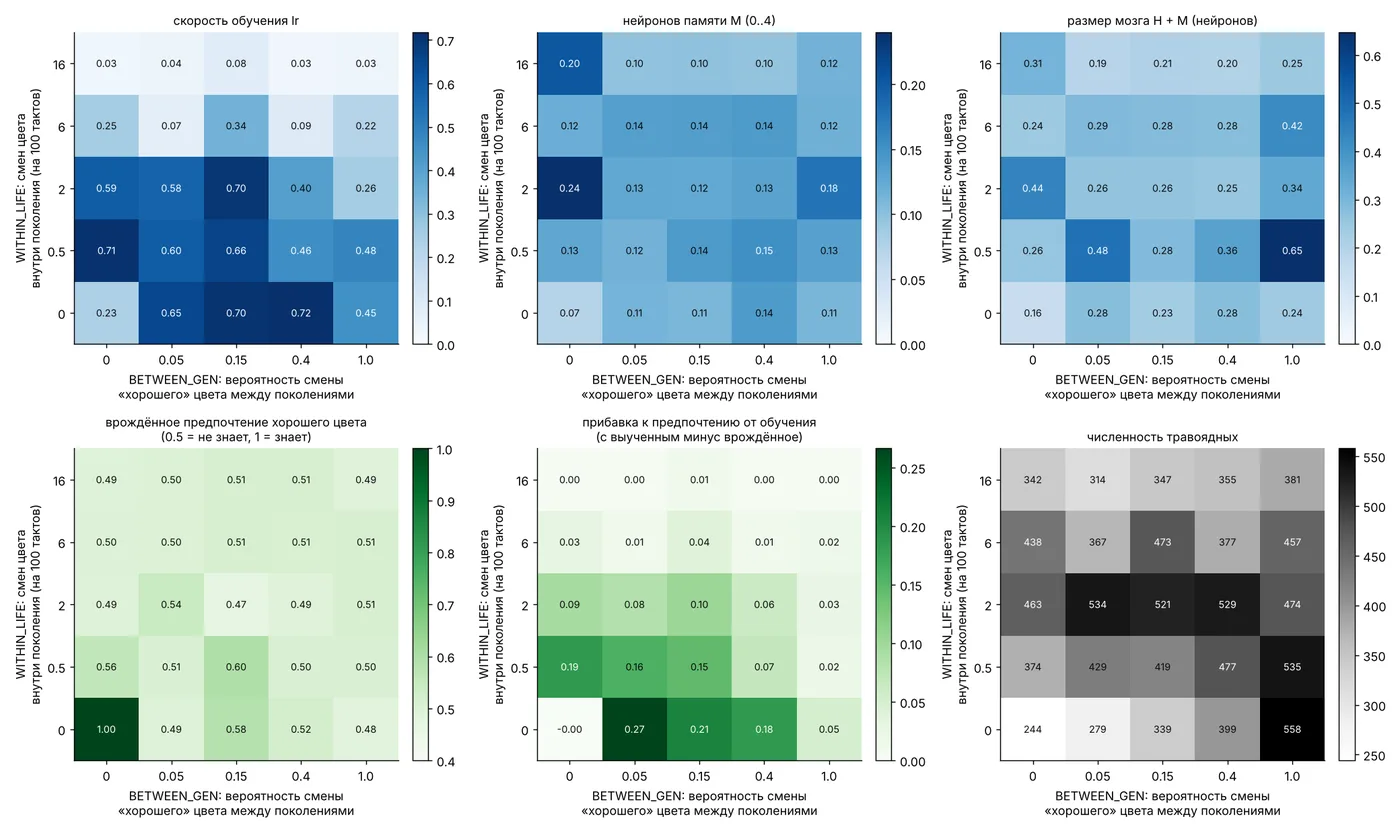
5 × 5 网格:横轴为代际之间的变化,纵轴为一生之内的变化。每格 6 次运行,每次 10,000 步。数字是进化达到的学习速率(从零开始)。
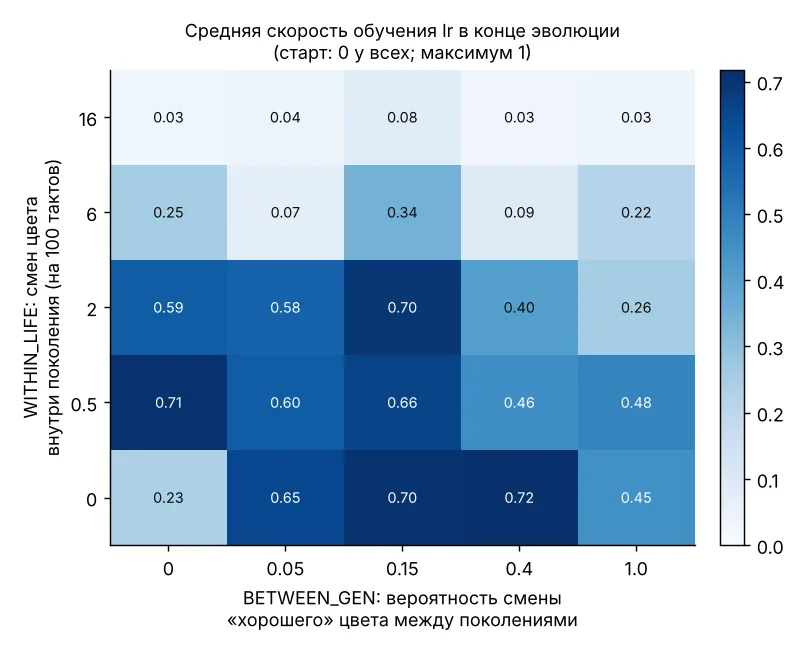
- 一生之内的快速变化会扼杀学习。这是最可靠的效应:颜色约每 6 步翻转一次时,学习速率几乎降到零(0.03)。
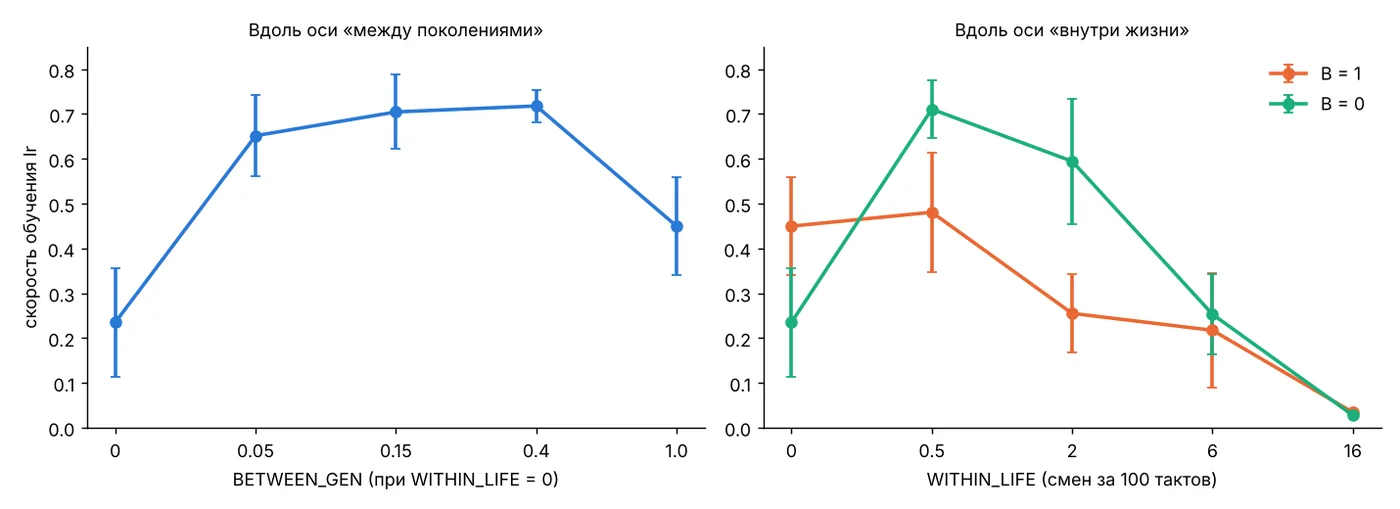
- 代际之间需要变化,但不是最大的变化。在一生之内稳定的那一行:0.23 → 0.65 → 0.70 → 0.72 → 0.45。峰值出现在大约每 2–3 代翻转一次,而不是每代都翻。
- 为什么峰值不在角落。模型中的世代是重叠的。如果颜色每 100 步翻转一次,对大多数成年个体来说这就是一生之内的变化,所有人学到的东西同时过时。所以在这个模型里两个旋钮并不完全独立。
- 为什么在稳定世界里学习不为零(0.23,分散度大):知识转入了基因,此后学习就没用了。但它很便宜,选择压力也很弱。
关掉学习:失去了什么
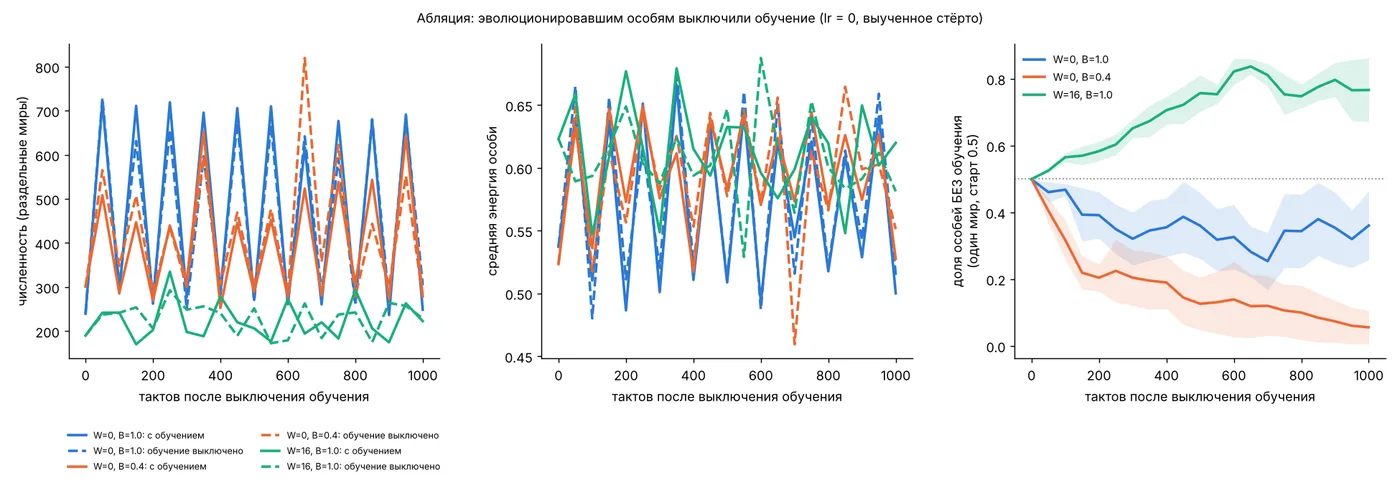
取进化后的种群,在世界的副本中关掉学习。用两种方式比较。
| 指标 | 每代都翻转 | 峰值点 | 对照:一生之内快速变化 |
|---|---|---|---|
| 无学习 / 有学习的种群数量(全部关掉) | 1.01 ± 0.08 | 1.08 ± 0.08 | 1.02 ± 0.06 |
| 最终“被关掉者”的比例(关掉一半,起始 0.5) | 0.36 ± 0.11 | 0.06 ± 0.06 | 0.77 ± 0.11 |
结论是两面的,这很重要。一个谁都不会学习的种群过得并不更差:数量和能量都在噪声范围内。但在直接竞争中,不学习者会输:在峰值点几乎一个都不剩。而在世界变化太快的地方,反倒是“被关掉者”获胜。
这和第一次迭代中的“追踪者”是同一幅图景:对个体有利的,不等于对种群有利。学习者从邻居那里抢走好食物,但食物总量并没有增加。
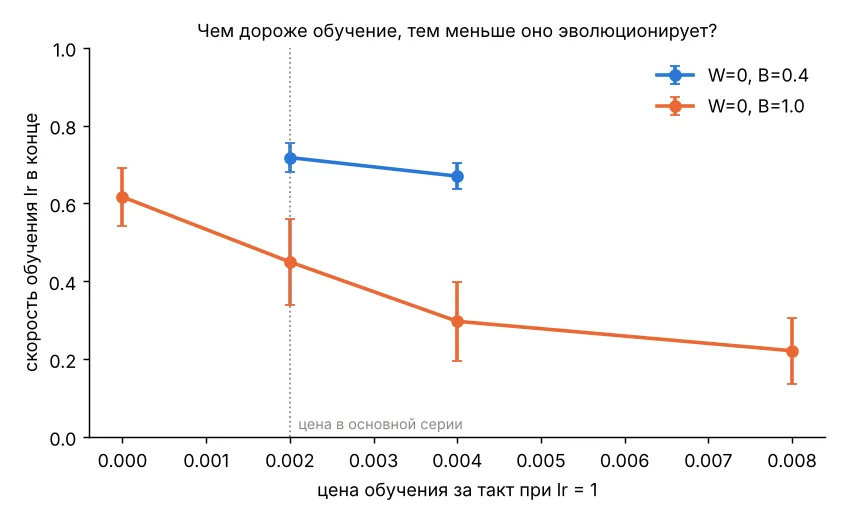
学习的代价起作用
| 学习代价 | 0 | 基准 | ×2 | ×4 |
|---|---|---|---|---|
| 最终学习速率 | 0.62 | 0.45 | 0.30 | 0.22 |
| 用于学习的能量占比 | 0 | 0.6% | 1.0% | 1.8% |
学习越贵,进化出的学习速率越低,而且关系是单调的。即使学习免费,也不会升到最大值:学得太快会带来噪声。每次运行都直接核实了代价确实被扣除。
结果稳健吗
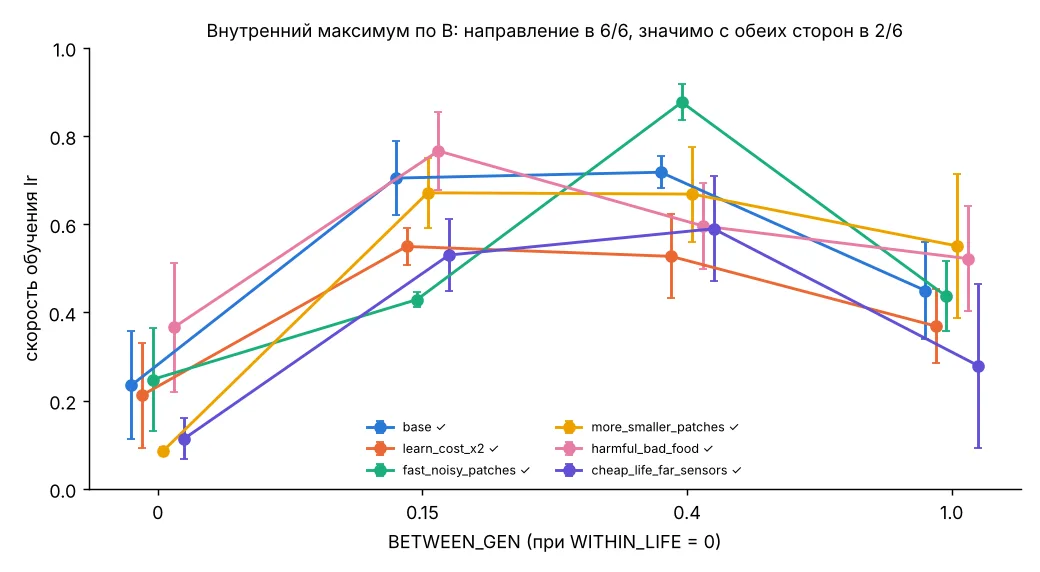
在五组相邻参数上重复:学习更贵、斑块更快更嘈杂、更多小斑块、“坏”食物有害、生活成本低且感知距离远。
- “一生之内的快速变化扼杀学习”——在 6 组中有 4 组显著。有一组无法比较:种群灭绝。另一组方向相同但分散度大。
- “代际之间有某种变化时学习比没有变化时更划算”——6 组全部显著。
- “适度变化比每代都变化更划算”——6 组方向一致,但只有 2 组显著。这是一个弱效应。
基因接管了知识
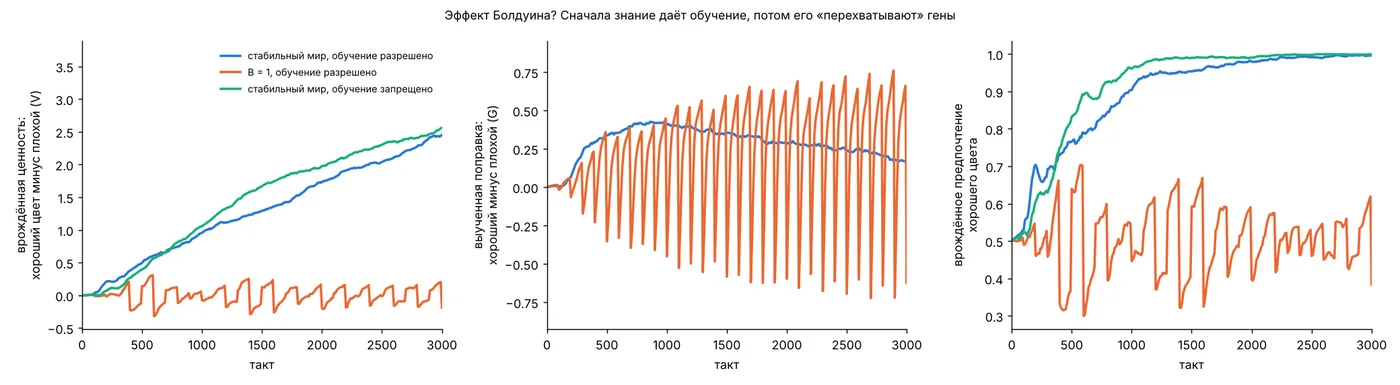
稳定的世界里能看到一个漂亮的现象:起初,关于好颜色的知识几乎一半来自学习。随后先天价值朝同一方向增长,追上并超过习得价值,而习得的修正降为零。已经没什么可学了:基因已经是对的。这叫作遗传同化。
但经典的鲍德温效应——学习加速先天知识的出现——没有得到证实。有学习时,基因得出答案并不比没有学习时更快:733 ± 197 步 对 640 ± 54 步。如果说有什么,倒是相反:能补学的个体较少受坏基因之害,因此对基因的选择更弱。
为什么在这个模型中如此:先天价值以小步变化,每一步都立即有用。选择不需要学习的提示。在经典的辛顿–诺兰模型中,只有完全正确的基因组合才有回报——“大海捞针”——学习在那里帮助找到它。
没有发生的事
- 大脑没有长大。所有点上隐藏神经元为 0.1–0.5,记忆神经元为 0.07–0.24,没有规律——只是零附近的突变背景。原因在于模型的设计:先天价值和习得价值都直接作用于行动选择,不经过神经元。“走向好颜色”不需要“大脑”就能解决,而记忆也不需要,因为习得价值本身就保存了过去。
- 童年没有出现。“父母喂养幼崽多少步”这个基因在所有测试点都停留在随机漂移水平(约 2 步)。模型中的幼崽只能从自己吃的食物中学习,所以喂养不会教会它任何东西,而对父母来说代价很高。
局限性。按神经元数量计的“大脑”没有长大:在模型中学习和神经元是彼此独立的。学习是专门为任务设计的;通用规则“根据奖励学习全部权重”在这个模型中有害。两个时间旋钮并不完全独立:世代重叠,这很可能是峰值出现在中间的原因。稳定世界是噪声最大的点。学习在种群层面没有好处。没有捕食者,世界很小(56 × 56,200–600 个个体),150 次运行中有 13 次以灭绝告终。显著性评估很粗略(差异大于两个标准误),且未做多重比较校正。
下一步
- 需要神经元的学习(网络内部的可塑突触)——重新把“学习”和“大脑大小”联系起来。
- 更严格地分离时间旋钮:离散世代,或把世界的“世代”与个体出生绑定。
- 把捕食者放回斑块世界。
- 社会学习:幼崽以父母为榜样学习。否则童年毫无用处。
- 在稳定世界和网格角落增加运行次数。
代码和原始数据在 evo-brain-sim 仓库中。欢迎通过 Telegram 讨论。