模型能否重现“猞猁–野兔”周期
世界上最著名的生态周期是加拿大的野兔和猞猁:大约每 10 年,它们的数量就会上下波动几十倍。我检验了我的玩具生态系统能否重现它。周期——能,很容易。其他一切——不能。
用真实数据校准模型的试点。问题不是“这对野兔是否成立”,而是“我们能否诚实地把模型与真实序列对比,并看清它在哪里失效”。2026 年 10 月。
模型是第一次迭代中的生态系统,但没有进化:食草动物和捕食者随机游走,能吃就吃。
简而言之
- 约 10 年的周期很容易得到。但这是一个弱检验:周期几乎完全由一个自由旋钮“一年等于多少个模型步”决定。
- 猞猁的滞后无法重现。数据中猞猁的峰值比野兔晚约 1.5 年。模型中晚 2.5–3 年,参数拟合几乎无法改变这一点。
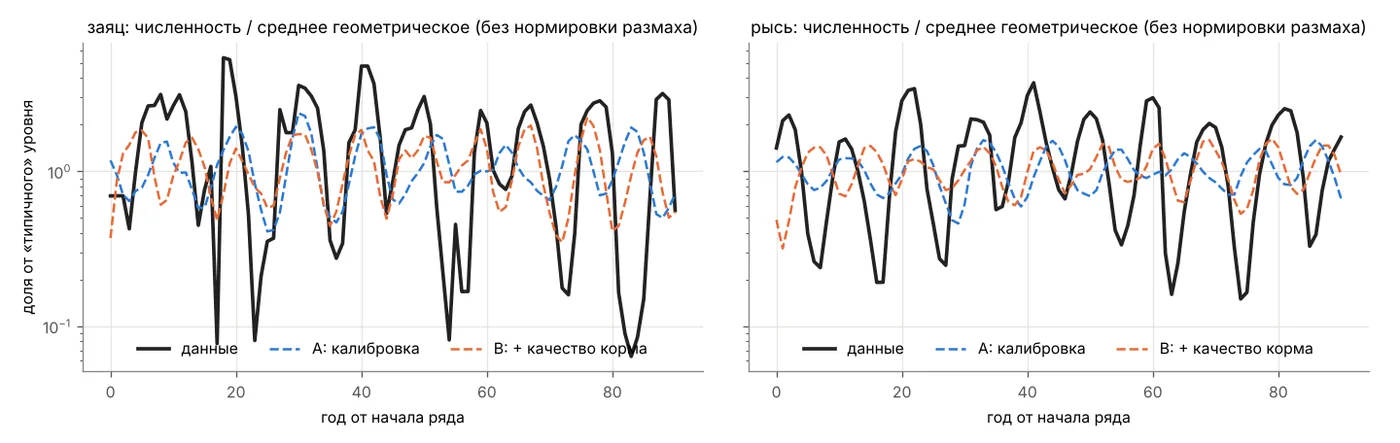
- 波动幅度比现实小 2–3 倍。真实的野兔从谷底到峰值相差约 40 倍,模型只有 3–5 倍。
- 周期的形状对上了,但几乎任何会循环的模型都能给出这种近似正弦的形状。证据很弱。
- 结论:有一个周期正确的循环,但不是真正的猞猁–野兔周期。两个有信息量的指标——滞后和振幅——都没有对上。
数据
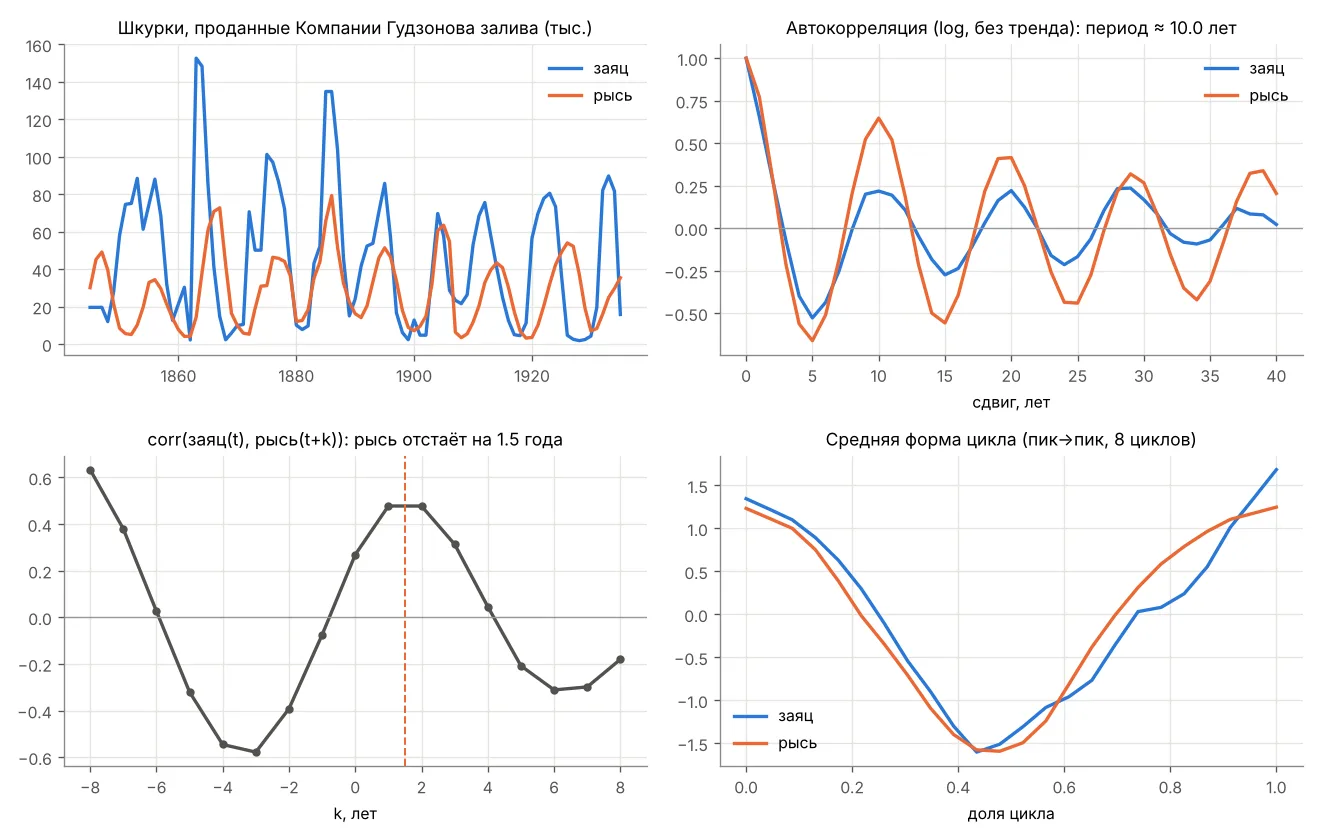
1845–1935 年猎人卖给哈德逊湾公司的雪鞋兔和加拿大猞猁毛皮数量。数字未经修改。另用麦肯齐河的猞猁序列(1821–1934)独立检验周期。
| 数据显示 | 数值 |
|---|---|
| 周期 | 约 10 年(麦肯齐河:9.7) |
| 猞猁比野兔滞后多少 | 1.5 年 = 0.15 个周期 |
| 波动幅度,野兔 / 猞猁 | 从谷底到峰值约 40 / 14 倍 |
| 周期中增长阶段的占比 | 两者都约为一半 |
野兔序列明显不如猞猁序列规律——这是毛皮记录的已知特点。
如何比较
- 比较的是形状,不是绝对数字。毛皮不等于种群数量,所以看的是周期、猞猁滞后、振幅和周期形状。
- 容差取自数据本身:每个指标在真实序列的 45 年滑动窗口中波动多少。“对上”表示差异在两倍波动范围以内。
- 只拟合了周期和滞后。用 CMA-ES 算法拟合了九个模型参数(植物生长、野兔代谢和死亡率、猞猁捕猎和死亡率、每年步数)。
- 振幅和形状留作检验,不参与拟合。如果模型是对的,它们应该自己对上。
- 防止拟合噪声:20 个最佳候选在 8 个新的随机种子上重新检验。下面所有数字都来自这些检验。
校准之前:用第一次迭代的参数,猞猁在所有运行中都灭绝。在 96 组随机参数中,两个种群都存活的有 31 组,出现明显周期的有 5 组。这五组中猞猁都滞后 0.28–0.32 个周期。
最好的结果
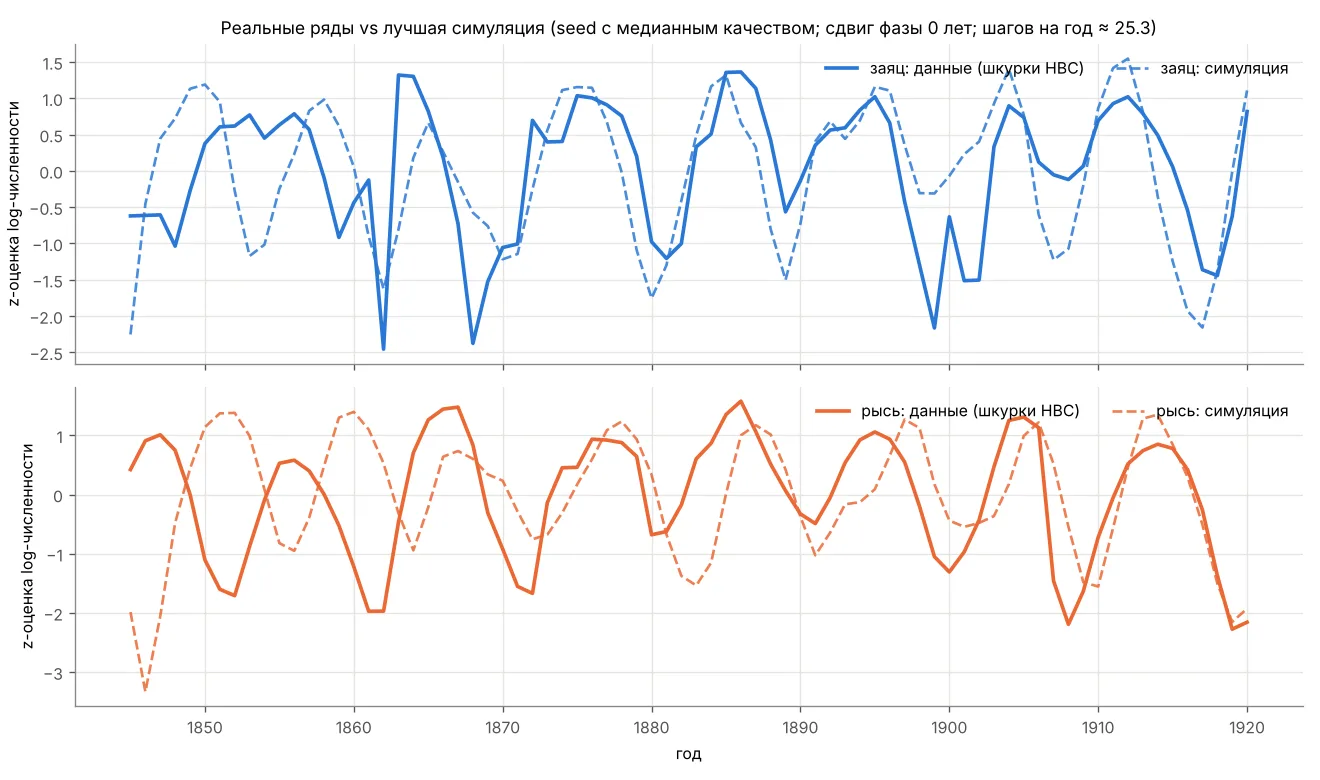
展示的是质量居中的运行,而不是最好的一次。序列经过标准化,模拟的起点被平移以与野兔的相位对齐。图中没有其他拟合。
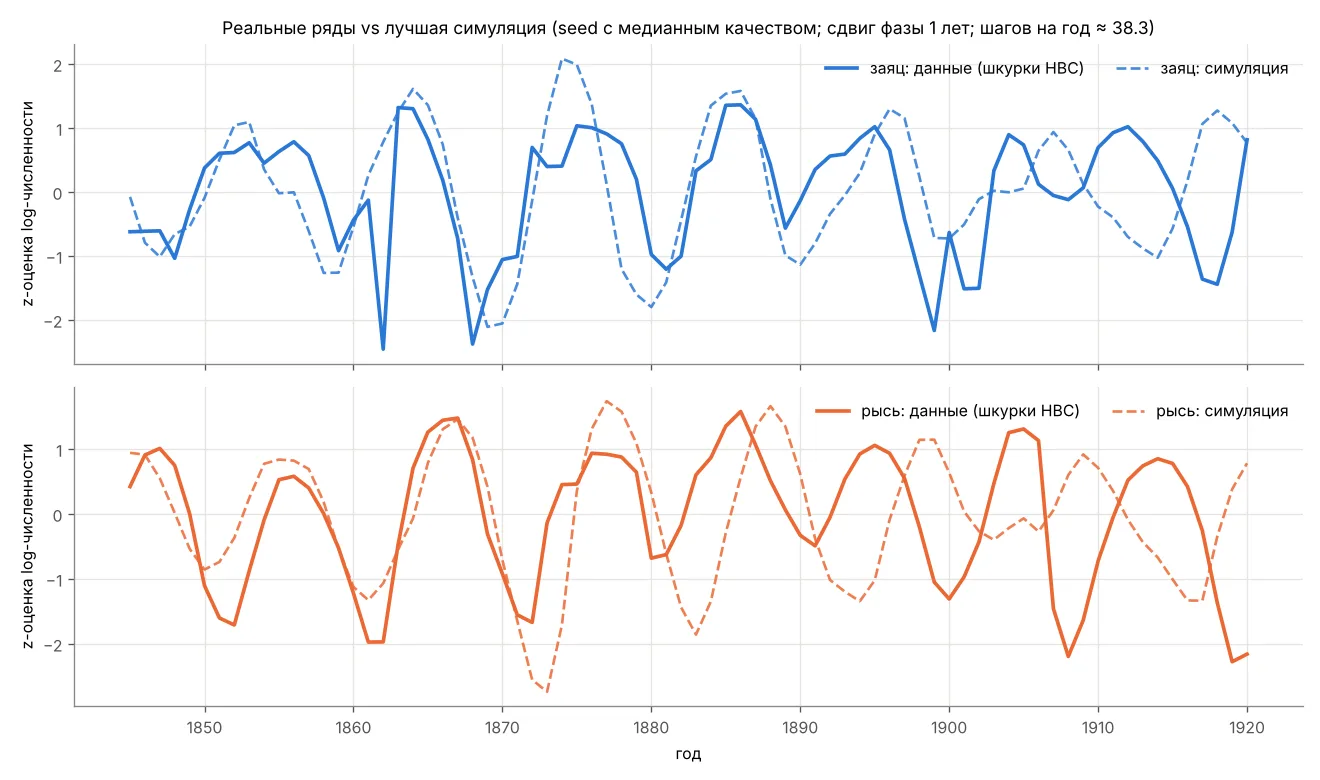
注意:标准化掩盖了主要的失败。不做标准化就能看出真实周期要深得多:
修正尝试:野兔多时食物变差
短滞后的经典解释是:野兔在猞猁峰值之前就开始减少,因为它们吃光了食物,植物也会自我防御。我加入了一个简单的反馈:野兔多时,食物质量延迟下降,野兔从进食中获得的能量减少。这就是校准 B。
- 拟合选择了很弱的效应:食物质量只在 0.88 到 0.92 之间波动。
- 不能更强:野兔会吃不饱而灭绝,猞猁随之灭绝。
- 滞后只略有改善(0.27 → 0.25 个周期),振幅没有增大,周期变得更不规律。
- 个别候选给出了约 0.20 的滞后,但周期几乎消失了。在这个模型里,短滞后是以破坏周期为代价换来的。
指标汇总
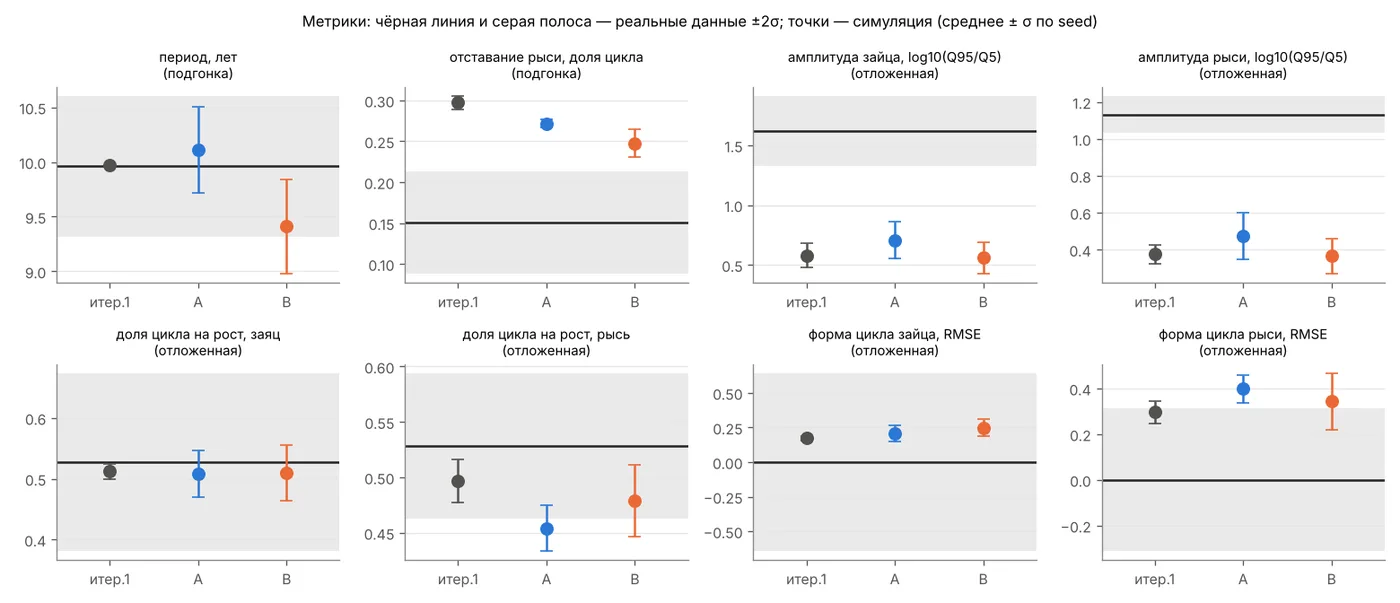
| 指标 | 数据 | A | B |
|---|---|---|---|
| 周期,年(拟合) | 9.96 | 10.11 ✔ | 9.41 ✔ |
| 猞猁滞后,周期占比(拟合) | 0.15 | 0.27 ✘ | 0.25 ✘ |
| 野兔振幅(留作检验) | 1.62 | 0.71 ✘ | 0.56 ✘ |
| 猞猁振幅(留作检验) | 1.13 | 0.47 ✘ | 0.36 ✘ |
| 野兔增长阶段占比(留作检验) | 0.53 | 0.51 ✔ | 0.51 ✔ |
| 猞猁周期形状(留作检验) | — | ✘ | ✘ |
振幅是高低水平之比的 log10;1.62 约等于 40 倍。✔ 表示差异在数据两倍波动范围以内。B 相对 A 的改进很小,统计上也不可靠,尽管 B 多了两个参数。
为什么很可能对不上
模型中的捕食者“靠能量储备”繁殖,对猎物的反应带有惯性,就像经典的洛特卡–沃尔泰拉模型。这样的系统会卡在约四分之一周期的滞后上。在现实中,野兔似乎在猞猁峰值之前就开始减少:因为食物、压力、其他捕食者。这种限制看起来是结构性的,而不是参数问题。
振幅小可能是因为世界小且具有空间性:56 × 56 网格上只有几百个个体,随机性和局部相遇抑制了大幅波动。
还有一个线索:在拟合出的时间尺度下,模型中的野兔在没有饥饿和捕食者时能活 4–7“年”,而真实的雪鞋兔只活 1–2 年。模型无法产生一个快速更替的猎物种群。
参数确定得如何
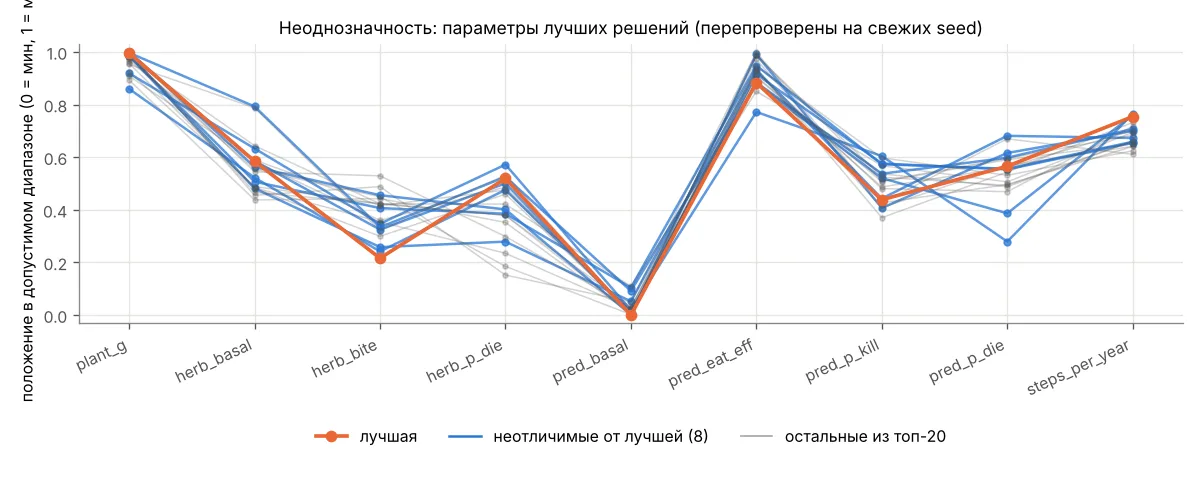
很差。在校准 A 中,20 个最佳候选中有 8 个彼此无法区分,猞猁死亡率在它们之间相差 25–40%。在 B 中,20 个里有 11 个无法区分,猞猁代谢相差 6 倍。仅凭周期和滞后,B 的参数几乎无法确定。而且这还是下限:所有候选都来自同一次拟合运行。
有几个参数碰到了允许范围的边界(植物生长取最大值,猞猁代谢取最小值)。这不是精确的信号,而是模型在“勉强”超出合理范围。边界被刻意没有放宽:用奇异的数值来拟合会让结果失去意义。
局限性。数据是毛皮数量,不是种群数量:它取决于毛皮价格、猎人投入和公司物流。滞后恰恰是贸易最可能扭曲的指标。只有一个序列,约 9 个周期,其自身指标就有噪声。周期几乎可以平凡地拟合,所以对上周期是弱成就。模型小且具有空间性,世界大小未被校准。结构变体 B 只有一个且很粗糙(全世界单一的食物质量)。不能保证拟合达到全局最优,尽管 96 个随机循环候选中没有一个滞后低于 0.28。
下一步
- 反向检验:拟合振幅和形状,检验滞后。
- 另一种结构:食物按网格局部延迟再生;更大或“空间性”更弱的世界。
- 观测模型:毛皮 = f(种群数量,猎人投入),带有独立噪声。在使用古数据之前需要这一步,因为那里“代理指标 ≠ 种群数量”的问题更严重。
- 用麦肯齐河序列独立检验:猞猁的周期和振幅。
代码、数据和所有图表都在 evo-brain-sim 仓库(calibration 文件夹)中。欢迎通过 Telegram 讨论。